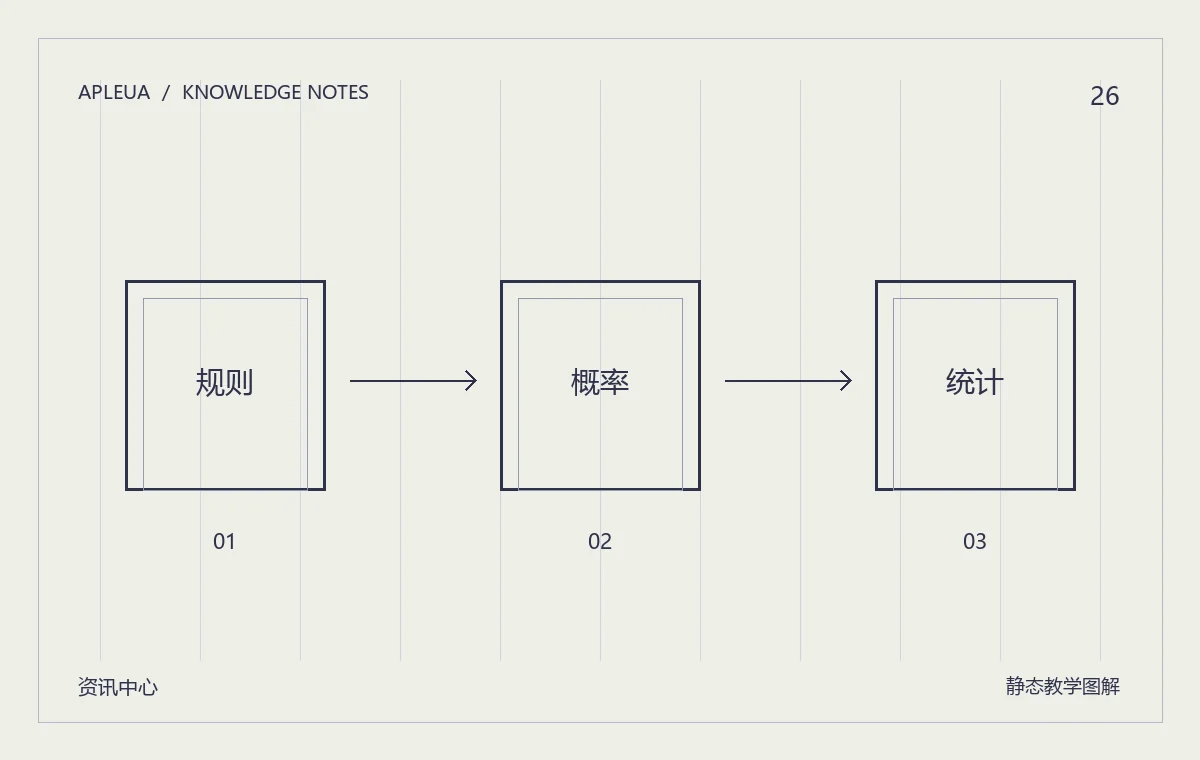
阅读射龙门相关内容时,规则、概率和统计经常出现在同一段话里。它们彼此关联,却回答不同的问题。建立一份层次索引,可以帮助你知道当前缺少的是定义、计数,还是样本说明,也能减少把历史频率直接当成单次预测的误解。
01规则层回答如何定义事件
规则首先规定对象、顺序与判定关系。例如端点是否算内部、A如何取值、同点边界怎样处理,都属于这一层。没有规则定义,就无法确定要数哪些对象。读者对某个例子有异议时,应先判断争议是否来自定义不同,而非直接对比小数。本站的规则栏目提供严格区间与特殊情形说明,适合在进入计算前阅读。
02概率层回答模型里有多少可能
当规则和抽样机制明确后,概率层才开始计数。在等可能实体模型中,计算符合条件张数占剩余总张数的比例。条件改变时需要更新,不能把一个比例当作永久标签。概率不负责规定实际版本流程,也不负责保证具体观察结果。它的强项是让给定假设下的可能性表达得更准确,而不是替代所有其他层次的问题。
03统计层回答记录呈现了什么
统计使用有限样本,讨论频率、分组、波动和误差。样本是否完整、口径是否一致、是否存在选择偏差,会影响它能支持哪些结论。理论概率与观察频率可以对照,却不能只因两者暂时不一致就认定模型一定错误,或认定下一次必须补偿。需要进一步检查样本量、机制假设和记录质量,才能知道差异意味着什么。
04将问题放回正确层次
“这张牌是否属于内部”应先找规则;“在这些条件下内部有多少可能”应找概率;“这组历史记录为什么偏离某个比例”应找统计与采集说明。有些综合问题需要依次穿过三层,但顺序不能倒置。特别是任何预测性主张,还要额外接受独立验证,不能因为引用了前面三层的术语,就默认已完成了对未来的检验。
纸上练习与独立核对
把你最近遇到的三个问题写在纸上,为每个标注规则、概率或统计。如果一个问题横跨多层,就将它拆成几个可以逐一回答的子问题。随后为每个子问题列出还缺的信息,而不急于寻找结论。例如“为什么这次没在内部”可能只是一次正常随机观察,并不自动要求修改规则。这样的索引能帮助阅读更有方向,也避免用更多术语掩盖真正的信息缺口。
把这一点带走
先定义,再计数,再解释样本。不同层次的问题,需要不同种类的依据。