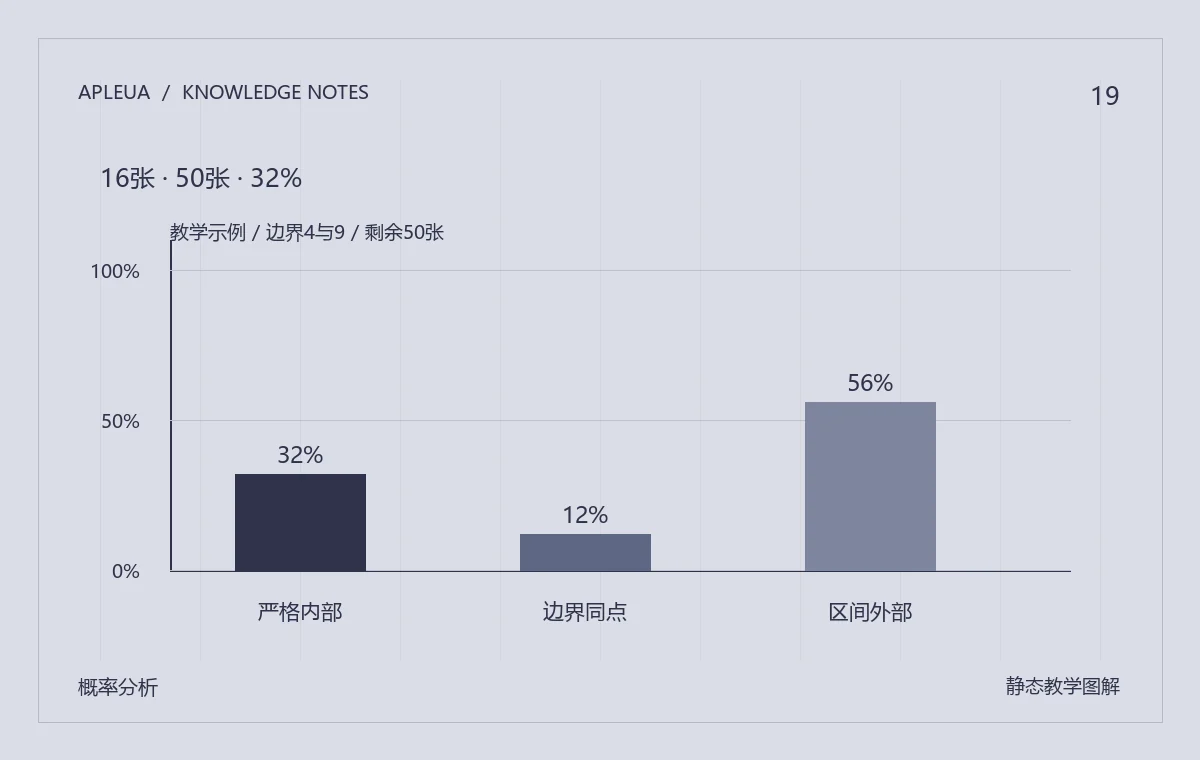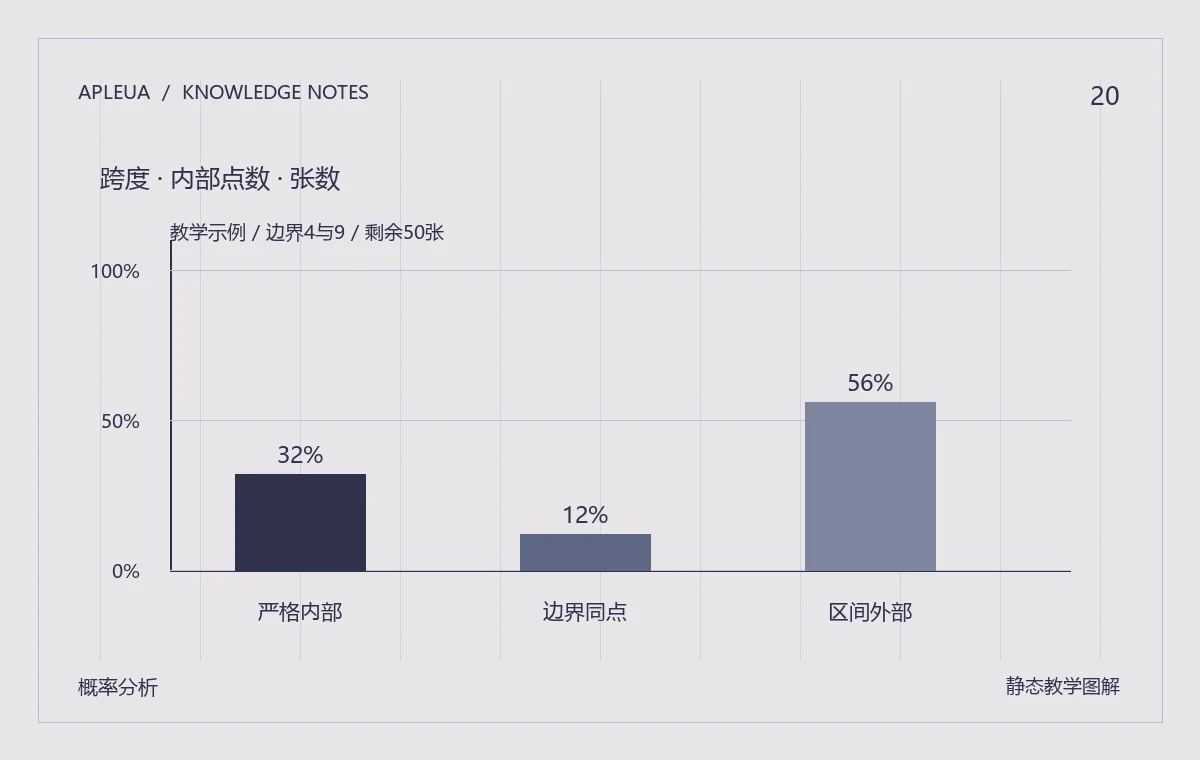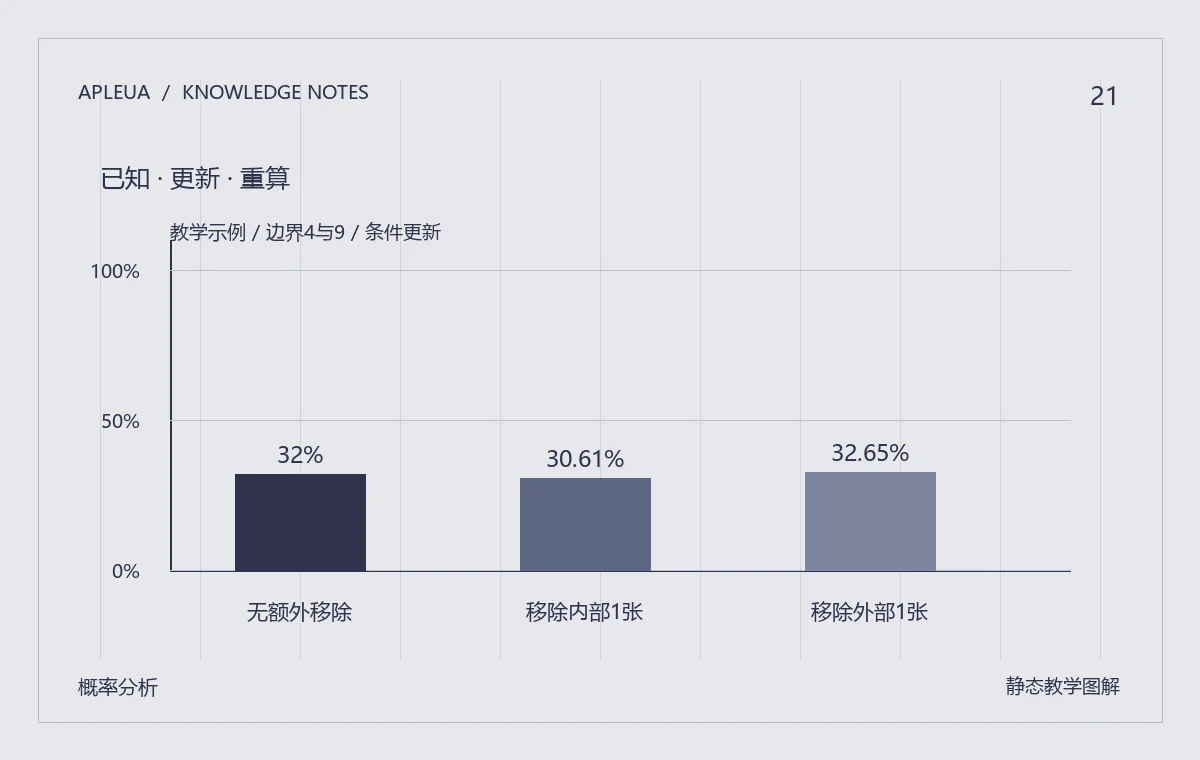
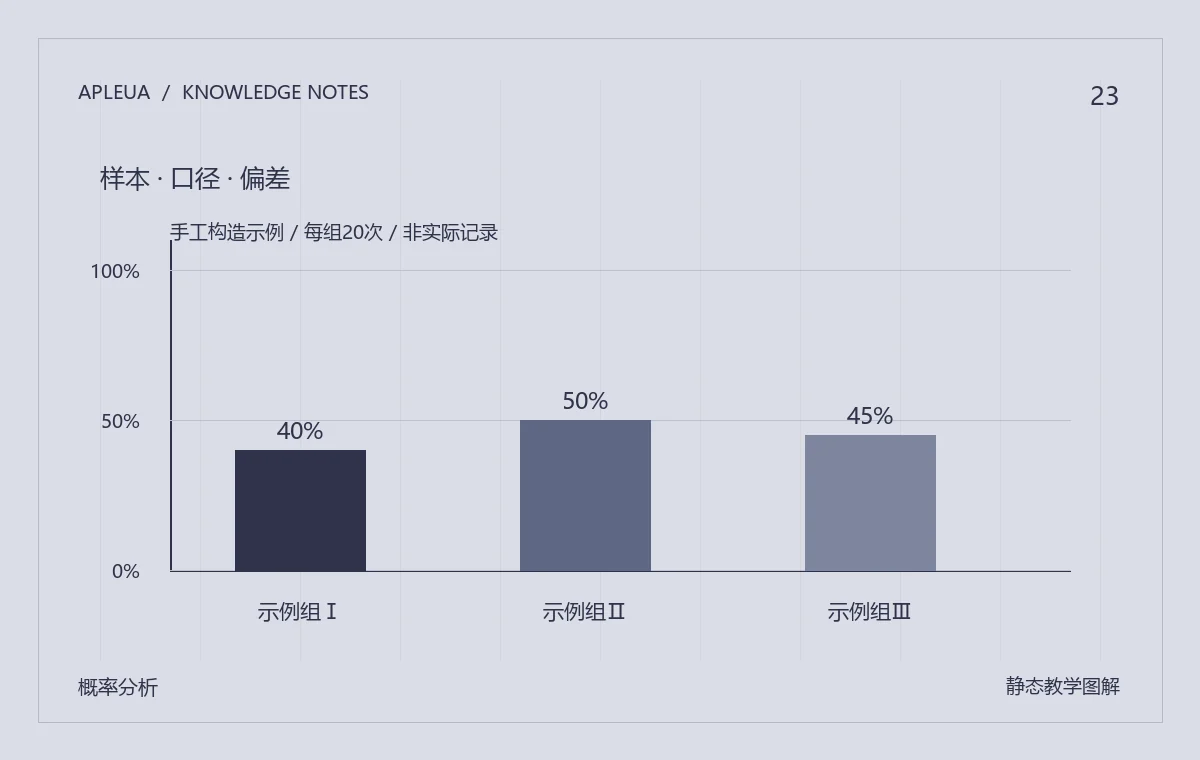
图表说明:本图为静态教学图解,并非实时数据、观察记录或预测结果。通用算例采用单副52张、A=1、严格区间与不放回观察;变更条件时在正文中单独说明。
历史记录可以帮助描述已经发生的情况,但一条折线并不自动回答下一次会怎样。读数据前,应先知道记录从哪里来、包含哪些观察,以及统计口径是否保持一致。本文关注描述性分析的基础,本站图表全部为明确标注的静态教学示例。
01先询问数据是怎样形成的
完整记录应有起止范围、观察单位、牌组条件与缺失说明。十次观察和一千次观察都可以计算频率,但不确定性并不相同。如果作者只写“样本很多”,却不提供数量和筛选方式,读者无法评估结论。来源不明的数据,即使有漂亮图表,也不能仅凭视觉精细程度获得可信度。应先检查采集和选择过程,再阅读趋势解释。
02统一分子、分母与分类定义
某份记录把端点归入内部,另一份排除端点,二者的频率不能直接拼接。不同跨度、不同牌堆状态也可能对应不同条件,把它们混成一个总体比例,会掩盖构成差异。整理时可以按明确条件分组,并保留每组样本量。任何百分数都应能回答“多少个符合条件的观察,占多少个有效观察”,否则小数本身没有充分上下文。
03选择偏差与缺失记录需要说明
只保留印象深刻的序列,或只截图成功片段,会让数据不再代表完整观察。漏记也不一定随机:人可能在疲劳或结果不满意时停止记录,使缺失与内容相关。分析时应区分原始记录、清洗规则和展示子集,避免无意中把筛选后的样本当成全部。不能恢复的缺失应标明未知,而非用想象中的平均结果填补后继续宣称准确。
04描述、解释和预测是不同任务
历史频率描述已记录的样本;解释需要结合机制和条件;预测则还需要检验在未来数据上的适用性。这三个任务逐层增加要求,不能因为描述图画得清楚就自动完成预测。即便样本比例接近理论概率,也不构成对单次结果的保证。一个负责任的图注应说明这是实际记录还是教学构造、使用何种口径,以及不应从图中推出什么。
纸上练习与独立核对
构造一份二十次纸上示例记录,分别按“严格内部”和“包含端点”计算比例,比较差异。再故意删除两条不喜欢的记录,看看展示结果怎样变化,并写明为什么这种筛选会破坏完整性。最后给表格补上标题、模型条件、样本量和“示例数据”标记。这些标注不是装饰,而是让另一位读者不必猜测就能知道数字在回答哪个问题。
把这一点带走
先审查来源和统计口径,再阅读趋势。描述历史不等于预测下一次。